홈 / 벤치마크, 평가, 보정

벤치마크, 평가, 보정

항목 27개

이 페이지는 영문 목록에서 생성했습니다.
이럴 때 유용합니다: 벤치마크와 평가

24

jev-benchmarks

타입 지정 결정 모델을 위한 확률 인지 평가입니다: 보정, 선택적 위험, 지연 시간을 재현 가능하게 다룹니다.

★ 27Python데이터셋 또는 벤치마크
벤치마크와 평가출력 검증

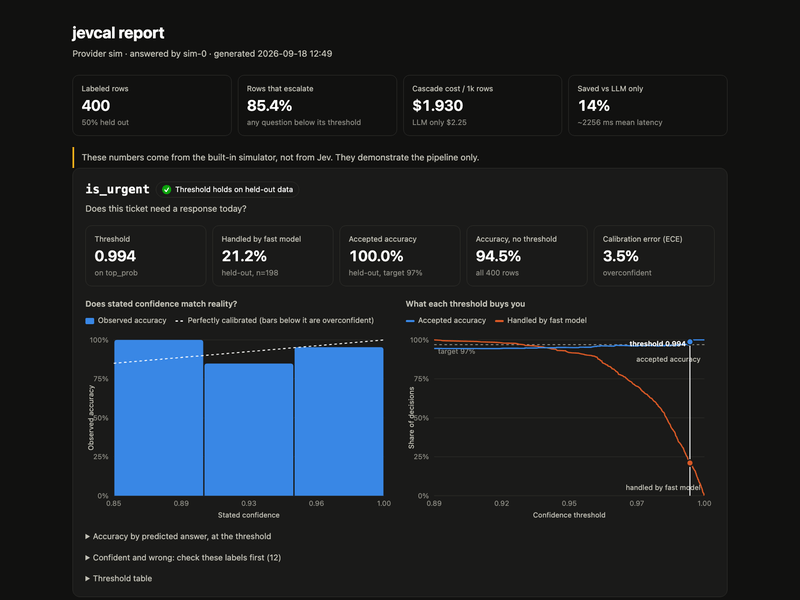
jevcal

임계값 추측은 그만두십시오: LLM 교사를 기준으로 보정하고 임계값을 정하고 드리프트를 점검하십시오.

★ 10PythonCLI
벤치마크와 평가출력 검증

jev-rerank-bench

데이터셋 14개에서 Jev를 Cohere Rerank, ZeroEntropy, 챗 기준선과 비교하며, 원본 응답도 포함합니다.

★ 11Python데이터셋 또는 벤치마크
벤치마크와 평가출력 검증

jev-search-rerank-eval

Jev 리랭크가 임베딩 검색을 이기는가? 채점된 쌍 9,831개를 쓰고 판정 순환성 편향도 측정했습니다.

★ 11Python데이터셋 또는 벤치마크
벤치마크와 평가검색 재정렬

jev-sec-bench

프롬프트 인젝션과 취약 코드 탐지를 위한 블라인드 벤치마크입니다.

★ 3Go데이터셋 또는 벤치마크
벤치마크와 평가출력 검증

jev-phishing-bench

피싱 이메일 2,000건에서 Jev와 Claude Haiku를 비교합니다: 정확도, 보정, 지연 시간, 비용을 다룹니다.

★ 10Python데이터셋 또는 벤치마크
벤치마크와 평가출력 검증

jev-spam-eval

Noul 질문으로 제로샷 스팸 필터링을 수행해 TF-IDF 기준선과 비교합니다.

★ 3Jupyter Notebook데이터셋 또는 벤치마크
벤치마크와 평가플레이그라운드와 데모

jev-agent-failure-benchmark

Who and When 에이전트 실패 귀인 벤치마크에서 Jev와 강력한 LLM을 비교합니다.

★ 4Python데이터셋 또는 벤치마크
벤치마크와 평가출력 검증

jev-korean-benchmark

한국어 이해와 의료 텍스트를 다루며, 실행 시간과 비용 근거를 함께 제시합니다.

★ 6Python데이터셋 또는 벤치마크
벤치마크와 평가출력 검증

jev-report

중국어로 작성된 독립 연구 보고서입니다: 52쪽, 재현 가능한 테스트 50개, 추적 가능한 데이터 143행입니다.

★ 1Python데이터셋 또는 벤치마크
벤치마크와 평가출력 검증

jev-benchmark

체스와 포식자 식별이라는 두 벤치마크로, 하나는 Jev의 영역 안에 있고 하나는 밖에 있으며 둘 다 결과가 있습니다.

★ 8Python데이터셋 또는 벤치마크
벤치마크와 평가플레이그라운드와 데모

jev-dspy-lab

DSPy에서 Jev 결정에 대한 재현 가능한 보정 및 선택적 위험 벤치마크입니다.

★ 16Python데이터셋 또는 벤치마크
벤치마크와 평가출력 검증

jev-eval-agent

목 도구 100개를 갖춘 개인 비서 에이전트로, Jev로 게이트된 에이전트가 몇 단계를 필요로 하는지 측정합니다.

★ 109HTML데이터셋 또는 벤치마크
벤치마크와 평가툴 호출 게이팅

jev-synergy-screening

초록 선별을 위해 Choice와 Noul 질문을 ASReview SYNERGY 골드 라벨에 대해 채점합니다.

★ 2Python데이터셋 또는 벤치마크
벤치마크와 평가출력 검증

jev-orderby-bench

Jev 확률에 대한 ORDER BY가 정당한지를 측정합니다: 사전 등록된 게이트 아래에서 쌍별 역전, 사람 등급 대비 Score 서수성, 보정, 표현 불변성을 점검하며, 20 Newsgroups 주제에서는 통과하고 Amazon ESCI 상품 관련도에서는 여섯 조건 중 넷을 실패하며, DuckDB 확장을 통한 40행 일괄 상태는 요청당 한 행이 통과하는 순위 게이트를 실패함을 보입니다.

★ 0Python데이터셋 또는 벤치마크
벤치마크와 평가출력 검증

cultivar

Pinecone의 스킬 테스트 CLI이며, LLM 채점기보다 약 30배 저렴하다고 보고하는 Jev 채점 백엔드를 갖췄습니다.

★ 42PythonCLI
벤치마크와 평가출력 검증

jev-eval by 4esv

라벨된 세 가지 과제에서 Jev와 GPT-5.6 Terra를 비교합니다: 쉬운 과제에서는 동등하고, 77지 라우팅에서는 6.7포인트 낮으며, 5배 빠르고 41~50배 저렴합니다.

★ 1Python데이터셋 또는 벤치마크
벤치마크와 평가출력 검증

jev-benchmark by themsquared

실행 간 분산을 함께 보고하는 도구 호출 위험 분류이며, 오답은 모두 유보적인 신뢰도를 동반했습니다.

★ 1Python데이터셋 또는 벤치마크
벤치마크와 평가출력 검증

jev-research-eval

고정된 jev-ultrafast 커밋 위에서 동작하는 재현 가능한 하네스이며, 기준선 및 스트레스 스위트를 포함합니다.

★ 3HTML데이터셋 또는 벤치마크
벤치마크와 평가출력 검증

jev-playground by hegargarcia

명시적 상태, 합법 행동, 측정 가능한 결과를 갖춘 게임에서 Jev를 다른 모델과 비교합니다.

★ 2TypeScript데이터셋 또는 벤치마크
벤치마크와 평가출력 검증

JevArena

직접 연결한 상대 심판과 Jev를 맞붙이는 호스팅 아레나입니다. 어느 쪽인지 밝히기 전에 투표를 받고 지연 시간, 비용 출처, 모델이 스스로 보고한 확신도를 보여줍니다. 투표가 기록하는 것은 선호이지 검증된 정답이 아닙니다.

★ 5TypeScript웹 앱
벤치마크와 평가플레이그라운드와 데모

JevBench

Jev 계열 결정 모델용 벤치마크입니다. 범위가 정해진 루브릭을 넣으면 선택지별 확률이 붙은 타입 지정 답변이 나오고, 캐스케이드와 위원회 실험은 따로 보고합니다.

★ 330Python데이터셋 또는 벤치마크
벤치마크와 평가출력 검증

jev-align

Jev 함수가 가장 확신하지 못하는 예시를 찾아 라벨을 요청하고, GEPA로 함수를 개선합니다.

★ 315PythonCLI
벤치마크와 평가분류와 추출

jev-fanout-bench

Jev 요청이 어떻게 과금되는지, 그리고 답이 배치, 번역, 바꿔 쓰기에서 얼마나 유지되는지 측정합니다. 과금된 요청 3,455건 기반이며 원시 로그를 공개합니다.

★ 0Python데이터셋 또는 벤치마크
벤치마크와 평가출력 검증

이럴 때 유용합니다: 출력 검증

2

jev-harness

신뢰도 게이트, 섀도 모드, 레시피, 평가를 제공하며, 같은 행 필터 작업에서 Claude CLI 48.9초 대비 Jev 1.3초를 보고합니다.

★ 15TypeScript라이브러리 또는 SDK
출력 검증벤치마크와 평가

jevals

트레이스의 에이전트, 품질, 보안 평가를 개별 LLM 심판 호출 대신 타입이 있는 Jev 질문 한 배치로 실행합니다.

★ 111Python라이브러리 또는 SDK
출력 검증벤치마크와 평가

이럴 때 유용합니다: 플레이그라운드와 데모

1

jev-behavior-study

jev-1.13.0에서 수행한 통제된 프롬프트 실험이며, 원본 결과와 오프라인 검증을 포함합니다.

★ 3Python데이터셋 또는 벤치마크
플레이그라운드와 데모벤치마크와 평가