ホーム / ベンチマーク・評価・較正

ベンチマーク・評価・較正

22 件

このページは英語版リストから生成しています。
こんなときに役立ちます: ベンチマークと評価

20

jev-benchmarks

型付き判断モデル向けの確率を考慮した評価で、較正、選択的リスク、レイテンシを再現可能な形で測ります。

★ 12Pythonデータセットやベンチマーク
ベンチマークと評価出力の検証

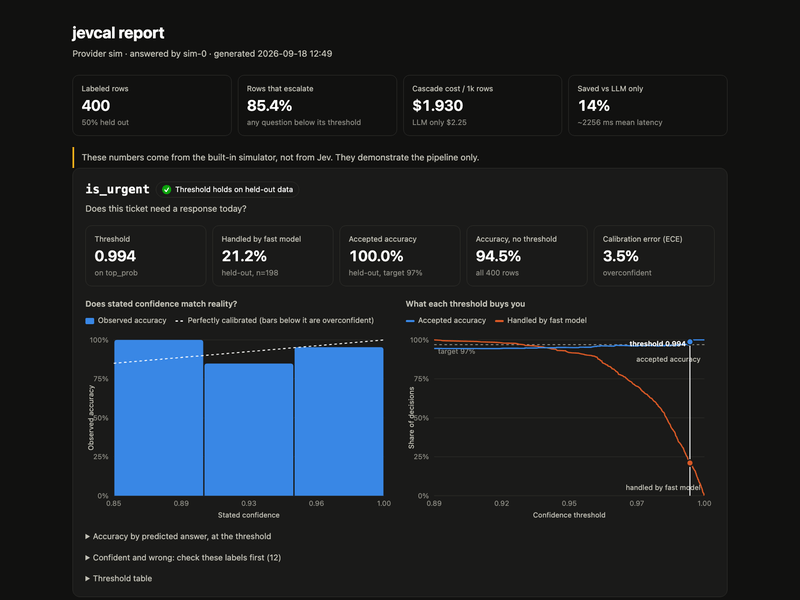
jevcal

しきい値の当てずっぽうをやめ、LLM の教師モデルに対して較正、しきい値設定、ドリフト検査を行います。

★ 8PythonCLI
ベンチマークと評価出力の検証

jev-rerank-bench

14 のデータセットで Jev を Cohere Rerank、ZeroEntropy、チャットのベースラインと比較し、生のレスポンスも同梱しています。

★ 2Pythonデータセットやベンチマーク
ベンチマークと評価出力の検証

jev-search-rerank-eval

Jev のリランクは埋め込み検索に勝てるのでしょうか。9,831 組の採点済みペアで、判定の循環によるバイアスも測定しています。

★ 4Pythonデータセットやベンチマーク
ベンチマークと評価検索結果の並べ替え

jev-sec-bench

プロンプトインジェクションと脆弱なコードの検出に関するブラインドのベンチマークです。

★ 2Goデータセットやベンチマーク
ベンチマークと評価出力の検証

jev-phishing-bench

2,000 通のフィッシングメールで Jev と Claude Haiku を比較し、精度、較正、レイテンシ、コストを測ります。

★ 2Pythonデータセットやベンチマーク
ベンチマークと評価出力の検証

jev-spam-eval

Noul の質問によるゼロショットのスパムフィルタリングを TF-IDF のベースラインと比較します。

★ 0Jupyter Notebookデータセットやベンチマーク
ベンチマークと評価プレイグラウンドとデモ

jev-agent-failure-benchmark

Who and When というエージェントの失敗要因特定ベンチマークで、Jev と強力な LLM を比較します。

★ 1Pythonデータセットやベンチマーク
ベンチマークと評価出力の検証

jev-korean-benchmark

韓国語の理解と医療テキストを、実行時間とコストの根拠付きで評価します。

★ 5Pythonデータセットやベンチマーク
ベンチマークと評価出力の検証

jev-report

独立した中国語の調査レポートで、52 ページ、50 件の再現可能なテスト、143 行の追跡可能なデータを含みます。

★ 0Pythonデータセットやベンチマーク
ベンチマークと評価出力の検証

jev-benchmark

チェスと捕食者の識別という 2 つのベンチマークで、Jev の得意領域の内と外を 1 つずつ扱い、どちらも結果が付いています。

★ 2Pythonデータセットやベンチマーク
ベンチマークと評価プレイグラウンドとデモ

jev-dspy-lab

DSPy における Jev の判断について、再現可能な較正と選択的リスクのベンチマークです。

★ 0Pythonデータセットやベンチマーク
ベンチマークと評価出力の検証

jev-eval-agent

100 個のモックツールを持つパーソナルアシスタントのエージェントで、Jev でゲートしたエージェントが何ステップを要するかを測定します。

★ 95HTMLデータセットやベンチマーク
ベンチマークと評価ツール呼び出しのゲート

jev-synergy-screening

Choice と Noul の質問を、抄録スクリーニングにおける ASReview SYNERGY の正解ラベルに照らして採点します。

★ 1Pythonデータセットやベンチマーク
ベンチマークと評価出力の検証

jev-orderby-bench

Jev の確率に対する ORDER BY が妥当かを測定し、事前登録されたゲートのもとでペアごとの逆転、人間の評点に対する Score の順序性、較正、言い回しの不変性を検査し、20 Newsgroups のトピックでは合格、Amazon ESCI の商品関連度では 6 条件中 4 つで不合格となり、DuckDB 拡張を通した 40 行のバッチ状態では、1 リクエスト 1 行なら通るランキングのゲートに落ちることを示しています。

★ 0Pythonデータセットやベンチマーク
ベンチマークと評価出力の検証

cultivar

Pinecone のスキル検証用 CLI で、LLM の採点者より約 30 倍安いと報告する Jev の採点バックエンドを備えます。

★ 40PythonCLI
ベンチマークと評価出力の検証

jev-eval by 4esv

ラベル付きの 3 つのタスクで Jev と GPT-5.6 Terra を比較し、易しいタスクでは互角、77 分類のルーティングでは 6.7 ポイント低く、5 倍速く、41 倍から 50 倍安いという結果です。

★ 1Pythonデータセットやベンチマーク
ベンチマークと評価出力の検証

jev-benchmark by themsquared

ツール呼び出しのリスク分類を実行ごとの分散付きで報告し、誤答はいずれも confidence が低めに出ていました。

★ 0Pythonデータセットやベンチマーク
ベンチマークと評価出力の検証

jev-research-eval

jev-ultrafast の特定コミットに固定した再現可能なハーネスで、ベースラインとストレスのスイートを備えます。

★ 2HTMLデータセットやベンチマーク
ベンチマークと評価出力の検証

jev-playground by hegargarcia

状態、合法な行動、測定可能な結果が明示されたゲームで、Jev と他のモデルを比較します。

★ 0TypeScriptデータセットやベンチマーク
ベンチマークと評価出力の検証

こんなときに役立ちます: 出力の検証

1

jev-harness

confidence のゲート、シャドーモード、レシピ、評価を備え、同じ行フィルタの処理で Claude CLI の 48.9 秒に対し Jev は 1.3 秒と報告しています。

★ 5TypeScriptライブラリや SDK
出力の検証ベンチマークと評価

こんなときに役立ちます: プレイグラウンドとデモ

1

jev-behavior-study

jev-1.13.0 に対する統制されたプロンプト実験で、生の結果とオフラインでの検証が付いています。

★ 3Pythonデータセットやベンチマーク
プレイグラウンドとデモベンチマークと評価