首页 / 基准、评测与校准

基准、评测与校准

27 条

本页由英文清单自动生成。
适合用来: 基准与评测

24

jev-benchmarks

面向带类型决策模型的概率感知评估:校准、选择性风险、延迟,可复现。

★ 27Python数据集或基准
基准与评测输出校验

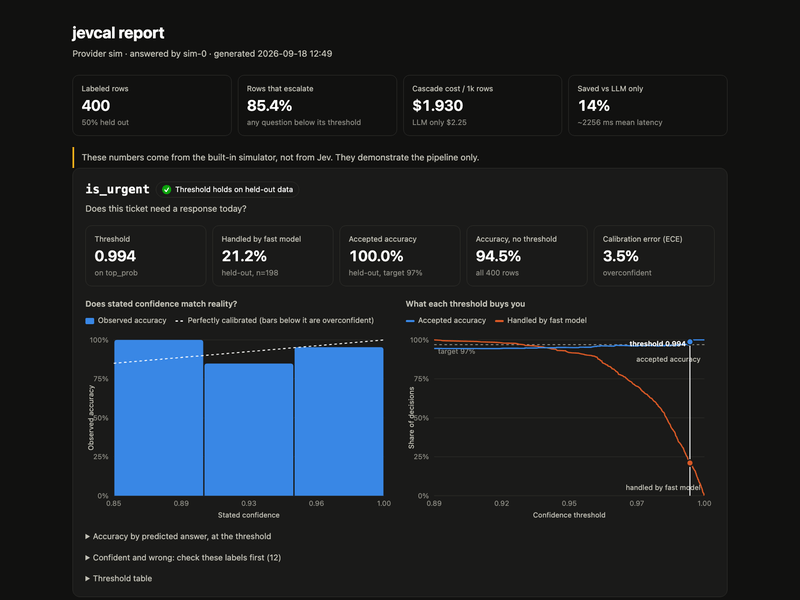
jevcal

别再猜阈值了:对照一个 LLM 教师做校准、定阈值和漂移检查。

★ 10Python命令行工具
基准与评测输出校验

jev-rerank-bench

在 14 个数据集上把 Jev 与 Cohere Rerank、ZeroEntropy 和一个聊天基线作对比,附原始响应。

★ 11Python数据集或基准
基准与评测输出校验

jev-search-rerank-eval

Jev 重排能胜过向量检索吗?9,831 对评分样本,并测量了评判循环性带来的偏差。

★ 11Python数据集或基准
基准与评测搜索重排

jev-sec-bench

针对提示注入和漏洞代码检测的盲测基准。

★ 3Go数据集或基准
基准与评测输出校验

jev-phishing-bench

在 2,000 封钓鱼邮件上把 Jev 与 Claude Haiku 作对比:准确率、校准、延迟、成本。

★ 10Python数据集或基准
基准与评测输出校验

jev-spam-eval

用 Noul 问题做零样本垃圾邮件过滤,对照 TF-IDF 基线。

★ 3Jupyter Notebook数据集或基准
基准与评测试玩与演示

jev-agent-failure-benchmark

在 Who and When 智能体失败归因基准上把 Jev 与一个强力 LLM 作对比。

★ 4Python数据集或基准
基准与评测输出校验

jev-korean-benchmark

韩语理解与医学文本,附运行时间与成本证据。

★ 6Python数据集或基准
基准与评测输出校验

jev-report

独立的中文研究报告:52 页,50 项可复现测试,143 行可追溯数据。

★ 1Python数据集或基准
基准与评测输出校验

jev-benchmark

两项基准测试,国际象棋和猛兽辨识,一项在 Jev 的能力区内、一项在区外,都附结果。

★ 8Python数据集或基准
基准与评测试玩与演示

jev-dspy-lab

针对 DSPy 中 Jev 决策的可复现校准与选择性风险基准测试。

★ 16Python数据集或基准
基准与评测输出校验

jev-eval-agent

带 100 个模拟工具的个人助理智能体,测量受 Jev 门禁的智能体需要多少步。

★ 109HTML数据集或基准
基准与评测工具调用把关

jev-synergy-screening

用 Choice 和 Noul 问题做摘要筛查,对照 ASReview SYNERGY 的金标准标注计分。

★ 2Python数据集或基准
基准与评测输出校验

jev-orderby-bench

衡量按 Jev 概率做 ORDER BY 是否站得住脚:成对逆序、Score 与人工评级的序数一致性、校准,以及预注册门禁下的措辞不变性;在 20 Newsgroups 主题上通过,在 Amazon ESCI 商品相关性上六项条件中有四项不通过,并表明通过 DuckDB 扩展做 40 行批量状态会不通过排序门禁,而每请求一行则通过。

★ 0Python数据集或基准
基准与评测输出校验

cultivar

Pinecone 的技能测试 CLI,带 Jev 评分后端,据报比 LLM 评分器便宜约 30 倍。

★ 42Python命令行工具
基准与评测输出校验

jev-eval by 4esv

在三项带标注的任务上把 Jev 与 GPT-5.6 Terra 作对比:简单任务打平,77 路路由低 6.7 分,速度快 5 倍,成本低 41 到 50 倍。

★ 1Python数据集或基准
基准与评测输出校验

jev-benchmark by themsquared

工具调用风险分类,附多次运行的方差;每一个错误答案都伴随着含糊的置信度。

★ 1Python数据集或基准
基准与评测输出校验

jev-research-eval

基于钉住的 jev-ultrafast 提交的可复现载体,含基线套件和压力套件。

★ 3HTML数据集或基准
基准与评测输出校验

jev-playground by hegargarcia

在状态明确、合法动作明确、结果可衡量的游戏中把 Jev 与其他模型作对比。

★ 2TypeScript数据集或基准
基准与评测输出校验

JevArena

在线竞技场:让 Jev 与你接入的对手裁判对战,先投票再揭晓谁是谁,并给出延迟、成本来源和模型自报的置信度;投票记录的是偏好,不是经过验证的正确性。

★ 5TypeScript网页应用
基准与评测试玩与演示

JevBench

面向 Jev 类决策模型的基准:输入有边界的评分标准,输出每个选项带概率的带类型答案,级联和委员会实验另行报告。

★ 330Python数据集或基准
基准与评测输出校验

jev-align

找出 Jev 函数最不确定的样例,请你标注,再用 GEPA 改进这个函数。

★ 315Python命令行工具
基准与评测分类与抽取

jev-fanout-bench

测量一次 Jev 请求的计费方式,以及答案在批处理、翻译和改写下是否稳定,基于 3,455 次计费请求,原始日志公开。

★ 0Python数据集或基准
基准与评测输出校验

适合用来: 输出校验

2

jev-harness

置信度门禁、影子模式、配方和评估;在同一个行过滤任务上报告 Claude CLI 用时 48.9 秒,Jev 用时 1.3 秒。

★ 15TypeScript库或 SDK
输出校验基准与评测

jevals

把一条 trace 的代理、质量和安全评估作为一批类型化 Jev 问题一次运行,取代多次独立的 LLM 评判调用。

★ 111Python库或 SDK
输出校验基准与评测

适合用来: 试玩与演示

1

jev-behavior-study

在 jev-1.13.0 上做的受控提示词实验,含原始结果和离线验证。

★ 3Python数据集或基准
试玩与演示基准与评测